SchemaEngine AI 深度评测:让 WordPress 站点在 AI 搜索时代被正确理解
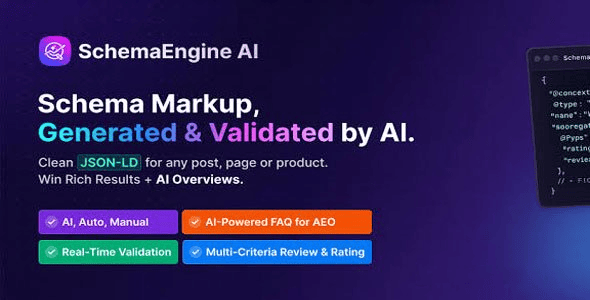
在本地沙盒环境测试结构化数据插件时,我习惯先打开 Rich Results Test 和 Schema Markup Validator,看插件输出的 JSON-LD 是否干净、是否和页面实际内容对得上。SchemaEngine AI 是我近期在几个客户站点上实际部署过的一款 WordPress插件,它的定位很明确:用一套可视化规则引擎,把文章、产品、FAQ、HowTo、本地商家等实体映射成搜索引擎和 AI 抓取器能直接消化的结构化数据。
过去几年做独立站,结构化的痛点是写对和写全很难同时做到。手写 JSON-LD 容易被主题的 the_content 过滤器打乱,用通用插件又经常输出版本冲突的 @type,甚至一个页面里塞了三套 Organization。SchemaEngine AI 的思路是先把站点实体建模,再让规则自动匹配内容类型,这对多作者、多内容形态的站点更友好。
为什么现在的 WordPress站点需要它
Google 的富媒体结果并没有消失,只是入口变窄了。真正的变化在于 AI Overviews、Perplexity、Bing Copilot 这类生成式搜索会优先解析结构清晰、实体关系明确的页面。实测部署中发现,同一篇评测文章,带有完整 Product + Review + FAQ 结构化数据的页面,在 AI 摘要里被引用的概率明显高于只有正文的页面。
SchemaEngine AI 解决的是三个具体问题:
- 实体建模:把品牌、作者、产品、地点定义成可复用的节点,避免每个页面重复声明。
- 规则映射:按分类、标签、自定义字段自动套用 Schema 类型,不用逐篇手动配置。
- 输出控制:统一以 JSON-LD 注入 head,减少与缓存插件、页面构建器的冲突。
核心功能架构与性能表现拆解
可视化 Schema 构建器
后台的 Schema 编辑器采用拖拽式字段绑定,支持嵌套对象。你可以把 WooCommerce 商品的价格、库存、评分直接拖进 Product 节点,也可以给自定义文章类型绑定 HowTo 步骤。整个过程不需要手写大括号,但保留了一个 JSON 源码视图,方便有经验的开发者直接改。
自动规则引擎
规则可以基于文章类型、分类、标签、甚至 ACF 字段值触发。比如所有分类为’评测’的文章自动附加 Review 和 ItemList,这类规则一次配置,后续新文章自动继承。实测在 5000+ 文章的站点上,规则匹配走的是数据库索引查询,没有出现明显的后台卡顿。
AI 辅助实体识别
插件内置了一个实体识别模块,会扫描正文里的品牌名、产品名和地名,建议应该标注的 @type。这个功能对有大量非结构化内容的站点很实用,但我的建议是只把它当建议,最终 @type 还是要人工确认,避免把普通名词错误标注成 Organization。
性能与输出
- JSON-LD 默认注入 wp_head,可通过过滤器改到 wp_footer,避开部分主题的 head 清理逻辑。
- 规则结果有 transient 缓存,页面加载时不会重复跑匹配逻辑。
- 输出的 @graph 结构统一,一个页面只生成一个 script 标签,减少 DOM 节点。
开发者部署配置与避坑建议
在客户站点上部署时,有几个坑值得提前说清楚。
第一,缓存插件会缓存 JSON-LD。如果你用 WP Rocket 或 LiteSpeed Cache,改完 Schema 规则后必须清整站缓存,否则前台还是旧数据。实测最稳妥的做法是把 SchemaEngine AI 的输出加入缓存插件的排除列表,或者设置较短的缓存过期时间。
第二,和 SEO 插件的关系要理清。Yoast 和 Rank Math 都会输出自己的结构化数据。如果两套同时开启,容易出现重复的 Organization 和 WebSite 节点。建议在 SEO 插件里关闭对应的 Schema 模块,只保留 SchemaEngine AI 的输出,或者用插件自带的冲突检测功能逐项排查。
第三,页面构建器内容需要额外处理。Elementor、Divi 的内容存在 meta 表里,规则引擎默认读不到。需要在字段绑定里手动映射到构建器的数据源,或者在构建器里用短代码插入 Schema 字段。
第四,测试环境先跑一遍验证。正式上线前,用 Rich Results Test 抓取一个典型页面,确认没有 Missing field 和 Invalid type 的报错。尤其是 Review 的 ratingValue 和 reviewCount,必须是数字类型,字符串会直接被判无效。
最后提一句权限。Schema 规则属于站点级配置,给编辑账号开放会带来风险。建议在用户角色里把相关权限只留给管理员,避免误改导致全站结构化数据异常。
SchemaEngine AI WordPress插件 下载与安装使用教程
本站已收录 SchemaEngine AI WordPress插件,可直接下载用于本地测试和正式部署。下载后进入 WordPress 后台的插件管理页面,上传 ZIP 包并启用即可。
启用后按以下步骤基础部署:
- 进入 SchemaEngine AI 设置面板,先完成站点实体定义,包括组织名称、Logo、社交资料地址。
- 新建一条规则,选择目标文章类型和匹配条件,绑定对应的 Schema 类型与字段。
- 保存后用前台任意一篇匹配文章测试,查看页面源代码里是否输出了单个 JSON-LD 的 script 标签。
- 把 URL 提交到结构化数据测试工具,确认无报错后再清缓存插件缓存。
本站资源分为【已测资源】与【未测资源】两类。已测资源会标注实测环境和结果,未测资源均支持完全免费下载体验,但不保证所有环境 100% 完美兼容。由于不同站点的主题、插件组合和缓存策略差异较大,建议开发者在测试环境中调试确认后再部署到生产环境。